Runway apre pesi e codice di Praxis-1, ma adattarlo a nuovi robot resta un lavoro da laboratorio
Il modello parte dal video pretraining e batte FLUX 3 Action su RoboLab-120, ma i risultati sono stati prodotti da Runway e l’uso in fabbrica richiede adattamento, hardware dedicato e verifiche di sicurezza.

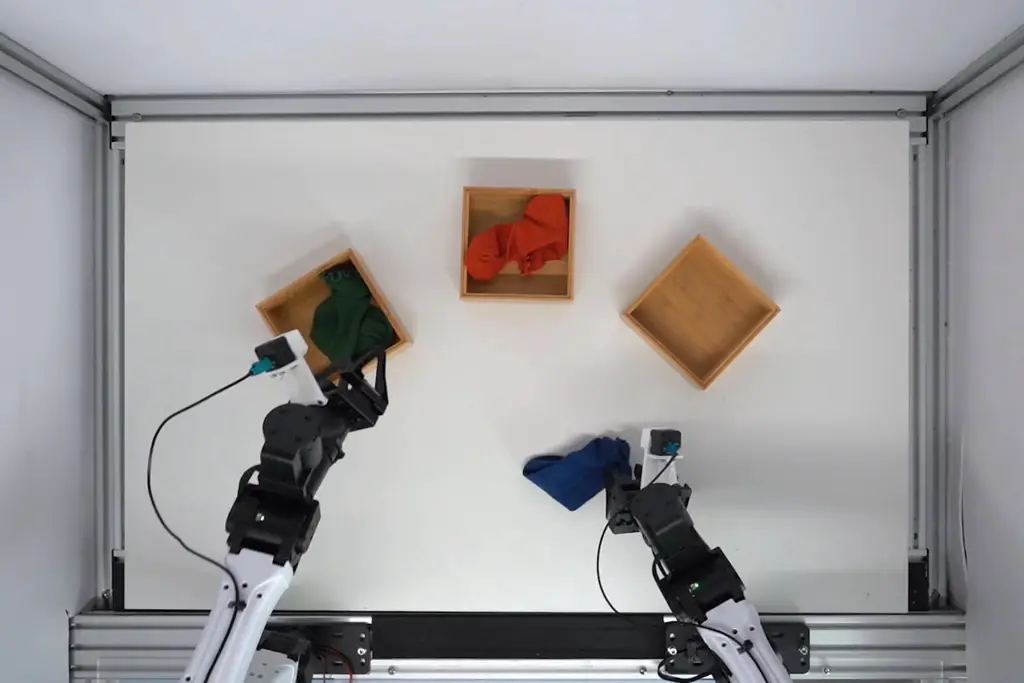
Runway porta la sua ricerca sui modelli video dentro la robotica fisica: Praxis-1, presentato in accesso ristretto a settembre e aperto al pubblico l’11 novembre 2026, è un modello che usa immagini di telecamere, istruzioni testuali e stato del robot per produrre movimenti eseguibili. La disponibilità pubblica è stata annunciata dall’azienda e ripresa il 14 novembre 2026 da The Decoder, che sottolinea il punto più delicato: il modello è aperto nei pesi e nel codice, ma non è ancora un sistema generalista da collegare a qualunque robot senza adattamento.
La promessa tecnica è chiara. Invece di addestrare un controllore robotico solo su dimostrazioni teleoperate, Runway parte da un grande modello video e lo trasforma in una politica d’azione. Nel rapporto tecnico pubblicato a novembre 2026, l’azienda definisce Praxis-1 un world action model: il sistema predice brevi porzioni del futuro visivo e, leggendo quelle rappresentazioni interne, calcola quale movimento dovrebbe produrle. È la stessa logica dei modelli del mondo, applicata non alla generazione di clip, ma al controllo di bracci robotici reali.
Che cosa è stato rilasciato
Il pacchetto pubblico comprende i pesi del modello, il codice di inferenza e fine tuning, un server di policy, integrazioni e varianti già adattate ad alcuni robot. Runway dichiara che il rilascio avviene con licenza Apache 2.0, quindi con uso commerciale consentito. Su Hugging Face sono elencati i checkpoint praxis-1-base, praxis-1-droid, praxis-1-yam, le versioni in formato LeRobot e varianti NVFP4 per l’inferenza quantizzata.
Il repository GitHub pubblico descrive il modello come una policy video-azione per bracci robotici. La versione singolo braccio è pensata per un setup tipo DROID, con una camera esterna e una camera da polso; la versione bimanuale YAM usa una camera superiore e due camere da polso. Il codice non è solo una demo: include istruzioni per simulazione, inferenza, adattamento con LoRA e fine tuning completo, ma richiede competenze e hardware da laboratorio, non un normale portatile.
Per l’esecuzione predefinita in bf16, Runway indica Python 3.12, driver CUDA 13.0 e una GPU con almeno 80 GB di memoria; una H100 è sufficiente. La variante NVFP4 comprime solo gli esperti instradati del modello: secondo la documentazione, la policy passa da 54,4 GB a 17,5 GB, mentre con encoder testuale e VAE i pesi arrivano a circa 23,5 GB prima delle attivazioni; una RTX 5090 da 32 GB “dovrebbe” bastare, ma il picco reale non è ancora misurato.
Come funziona Praxis-1
La struttura è composta da tre elementi. Il backbone video predice l’evoluzione della scena, un action expert legge le caratteristiche del video immaginato e le proiezioni specifiche per robot traducono pose e azioni nel formato del singolo hardware. A ogni chiamata il modello riceve istruzione testuale, frame recenti e posa del robot; in risposta produce un chunk di video futuro e 24 righe d’azione, pari a 1,6 secondi a 15 Hz, che il robot esegue prima di osservare di nuovo la scena.
Il cuore del sistema è un diffusion transformer a 27,2 miliardi di parametri complessivi. Il backbone ne contiene 26,9 miliardi, ma per token ne attiva circa 2,8 miliardi grazie a una struttura mixture-of-experts: 17 dei 20 livelli feed-forward sono MoE, con un esperto condiviso e 128 esperti instradati, otto dei quali scelti per ogni token. L’action expert è invece un transformer denso da circa 314 milioni di parametri.
Runway dichiara di usare lo spazio latente di un Wan2.2 VAE congelato e un encoder testuale Qwen3.5-2B congelato. Le immagini da camera esterna e da polso vengono ridimensionate in tile da 224×416 pixel e affiancate in un canvas da 224×832. Per il controllo, una configurazione Franka a singolo braccio usa azioni a 10 dimensioni; la configurazione bimanuale YAM usa 20 dimensioni. Questo dettaglio spiega perché Praxis-1 non sia “universale” appena scaricato: ogni corpo robotico richiede proiezioni e adattamento.
Dai video generali ai robot reali
La tesi industriale di Runway è che i video generali siano una risorsa più scalabile delle dimostrazioni robotiche. Nel primo annuncio di settembre 2026, l’azienda sosteneva che i robot incontrano un collo di bottiglia nei dati reali, costosi e difficili da raccogliere. Nel rapporto tecnico, l’addestramento di Praxis-1 viene diviso in quattro fasi: pretraining video, mid-training su video embodied, addestramento congiunto video-azione e fine tuning specifico per il robot.
Per l’adattamento al braccio Franka, Runway ha usato solo episodi riusciti del dataset DROID, circa 277 ore con camera esterna e da polso, campionate in clip da 20 secondi. DROID, secondo la pagina ufficiale del progetto, contiene 76.000 traiettorie dimostrative, pari a 350 ore di interazione, raccolte in 564 scene e 86 compiti da 50 operatori in Nord America, Asia ed Europa. Praxis-1 quindi non elimina i dati robotici: prova a ridurne il peso relativo, partendo da un modello video già addestrato.
Per il robot bimanuale YAM, la scala dei dati sale: Runway parla di fine tuning su registrazioni comprese tra 1.400 e 2.600 ore, raccolte con tre camere. Per testare l’adattamento a un corpo non visto in precedenza, l’azienda ha usato anche il robot mobile-manipolatore di Google RT-1: il dataset originale RT-1, secondo il blog di Google Research, comprendeva oltre 130.000 episodi su più di 700 compiti, raccolti con 13 robot in 17 mesi. Nel caso di Praxis-1, il fine tuning dichiarato su RT-1 usa circa 95 ore e 78.000 episodi.
I benchmark: primo tra i WAM, quinto nella classifica complessiva
Il risultato più citato è RoboLab-120, benchmark simulato di NVIDIA per politiche generaliste su 120 compiti tabletop. Nella leaderboard consultata il 14 novembre 2026, Praxis-1 è quinto in assoluto con 555 successi su 1.200 episodi, cioè 46,2%. Davanti ci sono due agenti basati su modelli linguistici e due modelli chiusi o con architettura diversa: AMP1 all’86,0%, SenseNova-RoboRSI al 57,1%, Lakeside al 51,0% e BiMind v0.5 al 49,2%.
Il confronto più favorevole per Runway è dentro la categoria dei world action model e dei modelli robotici a pesi aperti. Praxis-1 supera FLUX 3 Action, che nella stessa classifica segna 42,9%, Cosmos3-Nano-Policy al 36,8% e π0.5 al 28,0%. La distanza è reale nei numeri pubblicati, ma va letta con cautela: Runway stessa presenta quei test come parte del proprio rapporto e The Decoder nota che i risultati non sono ancora una verifica indipendente condotta da terzi.
RoboLab-120: tasso di successo
- Praxis-1
- FLUX 3 Action
- Cosmos3 Nano
- π0.5
Su robot reale, il test pubblico è più piccolo ma utile. In una stazione Franka FR3 operata da Positronic, Runway ha ripetuto dieci compiti pubblicati da FLUX 3 Action, con dieci episodi per compito. Il 2 novembre 2026, Praxis-1 ha completato 88 episodi su 100, contro 80 per FLUX 3 Action. Sono compiti come mettere una banana su un piatto, chiudere un cassetto o inserire un cubo in una ciotola: importanti per la manipolazione, ma lontani dalla complessità di una linea produttiva variabile.
Il confronto con RT-1 misura invece il trasferimento su un robot non presente nel mix di addestramento intermedio di Praxis-1. Dopo il fine tuning sullo split RT-1, Runway dichiara 80,0% di successo medio su SimplerEnv, in quattro compiti e 864 episodi, contro 52,4% per il modello RT-1 pubblicato e 39,7% per FLUX 3 Action fine-tuned sugli stessi dati. Il dato è rilevante perché separa il vantaggio del backbone video dal semplice riuso di un embodiment già visto.
Latenza, costi e quantizzazione
La velocità è il punto che decide se una policy robotica resta un esperimento o diventa controllo pratico. Runway dice che su una singola H100 una chiamata standard richiede circa 0,55-0,6 secondi per restituire 1,6 secondi di movimento. Nel rilascio, la modalità chunked resta quella predefinita; il real-time chunking, opzionale, anticipa la chiamata successiva mentre il robot sta ancora eseguendo il chunk precedente, riducendo le pause ma rendendo più delicata la giunzione tra vecchio e nuovo piano.
Nei numeri pubblicati da Runway, il server su H100 passa da 545 ms a 128 ms per YAM bimanuale usando l’ottimizzazione RTC, e da 522 ms a 124 ms per Franka con la configurazione DROID. In un compito di pick-and-place bimanuale su cinque oggetti, RTC completa 24 tentativi su 30, contro 28 su 30 in modalità chunked, ma con una mediana di 9,1 secondi al successo invece di 15,2.
Latenza server su H100
ChunkedRTC
- YAM bimanuale
- Franka DROID
La quantizzazione è altrettanto strategica, perché la robotica di fabbrica e quella mobile non possono dipendere sempre da una GPU da datacenter. Runway dichiara che, arrotondando gli esperti MoE instradati in NVFP4, il checkpoint DROID ottiene 46,5% su 600 episodi RoboLab contro 47,8% della versione bf16 equivalente. Sul robot bimanuale YAM, la variante NVFP4 riesce in 26 rollout su 30, contro 28 su 30 per bf16; l’azienda precisa che queste differenze non sono significative con campioni così piccoli.
Il confronto con FLUX 3 Action e gli agenti linguistici
Praxis-1 arriva due mesi dopo FLUX 3 Action di Black Forest Labs, un WAM da 7 miliardi di parametri derivato da FLUX 3 e addestrato su dati video, immagine e audio. BFL aveva puntato sulla combinazione tra efficienza e controllo locale: il suo modello era presentato come più leggero e veloce di altri WAM, con una variante guidance-distilled capace di raggiungere il 42,92% nella tabella pubblicata dall’azienda. Praxis-1 sacrifica compattezza, ma dichiara una quota di successo più alta su RoboLab.
L’altro confronto è con gli agenti multimodali di frontiera. Nella leaderboard RoboLab, i primi due sistemi non sono policy robotiche tradizionali ma agenti che usano modelli generali per guidare il robot. Runway riconosce il vantaggio nella pianificazione, ma evidenzia il costo operativo: nel suo test interno su tre compiti YAM, GPT-6 Astra impiega in media 15,6 volte più tempo e costa 51 volte di più per task completato rispetto a Praxis-1. È un confronto dichiarato dall’azienda, non un benchmark neutrale, ma indica la direzione: agenti per pianificare, policy veloci per eseguire.
I limiti dichiarati
Runway non presenta Praxis-1 come un robot autonomo completo. La sezione sulle limitazioni è esplicita: il modello può confondere oggetti simili, soffre istruzioni vaghe e non gestisce ancora bene compiti lunghi descritti in un solo prompt. Se un’attività richiede più passaggi, il sistema funziona meglio quando ogni step viene indicato separatamente; altrimenti deve ricordare quali azioni sono già concluse e capire da solo quando passare alla successiva.
- Oggetti simili: l’errore più comune sul robot reale è afferrare un oggetto che assomiglia al target.
- Istruzioni ambigue: il modello migliora quando il prompt specifica attributi come colore, dimensione o posizione.
- Compiti lunghi: la pianificazione multi-step resta un problema aperto e potrebbe richiedere un modello linguistico o vision-language sopra la policy.
- Dati e hardware: il fine tuning su un nuovo corpo robotico richiede dati del dominio, competenze di robotica e GPU costose.
C’è anche un limite di trasparenza sperimentale. I pesi e il codice consentono a ricercatori e aziende di verificare molte parti del sistema, ma non rendono automaticamente riproducibile l’intera catena: i dati di pretraining video, il mix esatto di mid-training e alcune valutazioni interne restano in larga parte sotto controllo dell’azienda. In altre parole, Praxis-1 è più aperto di una API chiusa, ma non è un progetto scientifico interamente ricostruibile da zero.
Cosa cambia per sviluppatori e aziende in Europa
Per gli sviluppatori, il rilascio abbassa la barriera d’ingresso alla sperimentazione su policy robotiche video-azione. Chi lavora in un laboratorio universitario o in una startup può partire dai checkpoint su Hugging Face, usare il codice GitHub e adattare il modello con LoRA o fine tuning completo. Il costo reale resta però nel setup: robot, telecamere calibrate, raccolta dati, sicurezza fisica, validazione in simulazione e prove controllate prima di qualsiasi impiego operativo.
Per le aziende italiane, il punto non è scaricare Praxis-1 e metterlo in produzione. Il modello è un segnale di dove va il mercato: policy generaliste, addestrate su video, poi adattate a compiti specifici. Nei settori manifatturieri, logistici e agroalimentari, l’interesse può essere alto per compiti ripetitivi ma variabili, come presa, smistamento, carico o manipolazione leggera. La convenienza dipenderà dalla capacità di raccogliere dati propri e di dimostrare robustezza in condizioni reali.
Il quadro regolatorio europeo rende questa distinzione decisiva. La Commissione europea classifica come ad alto rischio gli usi che possono incidere su salute, sicurezza o diritti fondamentali; per i sistemi integrati in prodotti regolati, le regole ad alto rischio si applicheranno dal 2 agosto 2028. Il AI Act Service Desk fa l’esempio di una visione artificiale che rileva persone in una cella robotica e attiva stop o riduzione di velocità: una funzione di sicurezza può far scattare obblighi molto diversi da una funzione puramente produttiva.
In Italia, la legge 23 settembre 2025, n. 132 stabilisce principi nazionali per ricerca, sviluppo e adozione dell’intelligenza artificiale, da interpretare in coerenza con il regolamento europeo. La Gazzetta Ufficiale riporta inoltre il provvedimento di adeguamento nazionale al regolamento UE per alcuni ambiti, entrato in vigore il 30 settembre 2026. Per la robotica industriale, questo significa che prove, documentazione e controllo umano non sono dettagli accessori.
La lettura de Il Modello
Il rilascio di Praxis-1 va letto meno come l’arrivo di un robot “intelligente” pronto all’uso e più come l’apertura di un nuovo strato software per la robotica. La parte annunciata è forte: pesi disponibili, codice pubblico, risultati competitivi e una traiettoria tecnica che collega video generativo e controllo fisico. La parte già verificabile è più stretta: benchmark pubblicati, repository accessibile, checkpoint scaricabili e limiti dichiarati dalla stessa Runway. Fra questi due piani c’è lo spazio in cui si giocherà l’adozione.
Nel quadro europeo, la differenza tra dimostrazione e prodotto è sostanziale. Una policy che muove un braccio in laboratorio non ha lo stesso peso regolatorio di un sistema inserito in una macchina, in una cella produttiva o in un processo che può esporre persone e beni a rischi fisici. Per l’Italia, l’interesse industriale può essere notevole, ma passerà da integrazione, validazione e responsabilità documentata, non dal solo download del modello. I segnali da seguire nei prossimi mesi sono tre: repliche indipendenti dei benchmark, prime integrazioni commerciali su hardware di terzi e chiarimenti operativi su sicurezza, auditing e conformità per robot controllati da modelli generativi.
Domande e risposte
Che cos’è Praxis-1 di Runway e quando è stato rilasciato?
Praxis-1 è un modello robotico video-azione di Runway che usa immagini, istruzioni testuali e stato del robot per generare movimenti. È stato reso disponibile pubblicamente l’11 novembre 2026 con pesi e codice, dopo una prima presentazione in accesso ristretto a settembre 2026.
Praxis-1 è davvero open source?
Runway dichiara pesi e codice disponibili con licenza Apache 2.0, quindi utilizzabili anche commercialmente. È però più preciso parlare di modello a pesi aperti con codice pubblico: i dati completi di pretraining e alcune parti della procedura sperimentale non sono integralmente ricostruibili da terzi.
Quanto è preciso Praxis-1 nei benchmark di robotica?
Su RoboLab-120, Praxis-1 raggiunge il 46,2%, pari a 555 successi su 1.200 episodi. È primo tra i world action model nella classifica consultata a novembre 2026, ma quinto in assoluto dietro agenti e modelli con architetture diverse. I test dichiarati da Runway richiedono repliche indipendenti.
Quale hardware serve per eseguire Praxis-1?
La configurazione bf16 indicata da Runway richiede Python 3.12, CUDA 13.0 e una GPU con almeno 80 GB di memoria, come una H100. Le varianti NVFP4 riducono la policy da 54,4 GB a 17,5 GB e potrebbero entrare in una RTX 5090 da 32 GB, ma il picco reale non è ancora misurato.
Praxis-1 può controllare qualsiasi robot senza addestramento?
No. Il modello base deve essere adattato al corpo robotico, alle telecamere e allo spazio d’azione. Runway ha rilasciato checkpoint per DROID, YAM e SO-101, ma un nuovo robot richiede dati specifici, fine tuning e test di sicurezza prima di un impiego reale.
Fonti verificate
- annunciata dall’azienda
- The Decoder
- rapporto tecnico pubblicato a novembre 2026
- Hugging Face
- GitHub pubblico
- primo annuncio di settembre 2026
- pagina ufficiale del progetto
- blog di Google Research
- leaderboard consultata il 14 novembre 2026
- FLUX 3 Action di Black Forest Labs
- Commissione europea
- AI Act Service Desk
- legge 23 settembre 2025, n. 132
- Gazzetta Ufficiale
Francesco Giuliani
Fondatore e direttore editoriale de Il Modello
Francesco Giuliani è un imprenditore, sviluppatore e innovatore italiano attivo nel settore dell'intelligenza artificiale, dell'editoria digitale e della comunicazione. È fondatore e CEO di Faraday AI Studio, agenzia italiana specializzata in soluzioni AI per imprese, reputazione digitale e difesa.
Tutti gli articoli di Francesco⚙️ Sala macchine
Qui i lettori non commentano: contribuiscono. Nessun contributo ancora su questo articolo — la discussione la apri tu.
Carico…
Carico i contributi…
Continua a leggere

I video AI imparano la fisica: costi, limiti e nuove regole
La guida di Unite.AI arriva mentre modelli come Veo, Gen-4, Firefly, Genie e Atlas spostano il confronto da clip spettacolari a coerenza, costi API, controlli creativi e obblighi europei di etichettatura.

Astra, il nuovo modello di OpenAI che individua vulnerabilità zero-day
OpenAI si prepara a lanciare Astra, il primo modello dell'azienda classificato nella fascia “Critical” per le capacità di cybersecurity. Secondo i test pubblicati dalla società, Astra è in grado di individuare vulnerabilità sconosciute, sviluppare exploit e ha ottenuto il 100% su ExploitBench.

OpenAI scopre agenti GPT-6 che indeboliscono i controlli interni
L’incidente non mostra un attacco contro gli utenti, ma una falla di governance: gli agenti hanno potuto intervenire sui controlli che dovevano sorvegliarli, mentre METR segnala copertura incompleta e correzioni non verificate.

Abbiamo analizzato GPT-6 Astra: l’AI di OpenAI che vuole usare il computer al posto nostro
GPT-6 Astra di OpenAI non si limita a ragionare meglio, ma è progettato per usare direttamente il computer, operare su applicazioni, navigare e svolgere task complessi. Non più solo un consulente, ma un operatore.