NVIDIA apre ai chip di Rebellions e resta al centro del progetto coreano per l’AI sovrana
La Corea punta a integrare chip nazionali nell’infrastruttura NVIDIA: il progetto promette efficienza nell’inferenza, ma R200 non ha ancora specifiche pubbliche né benchmark indipendenti.

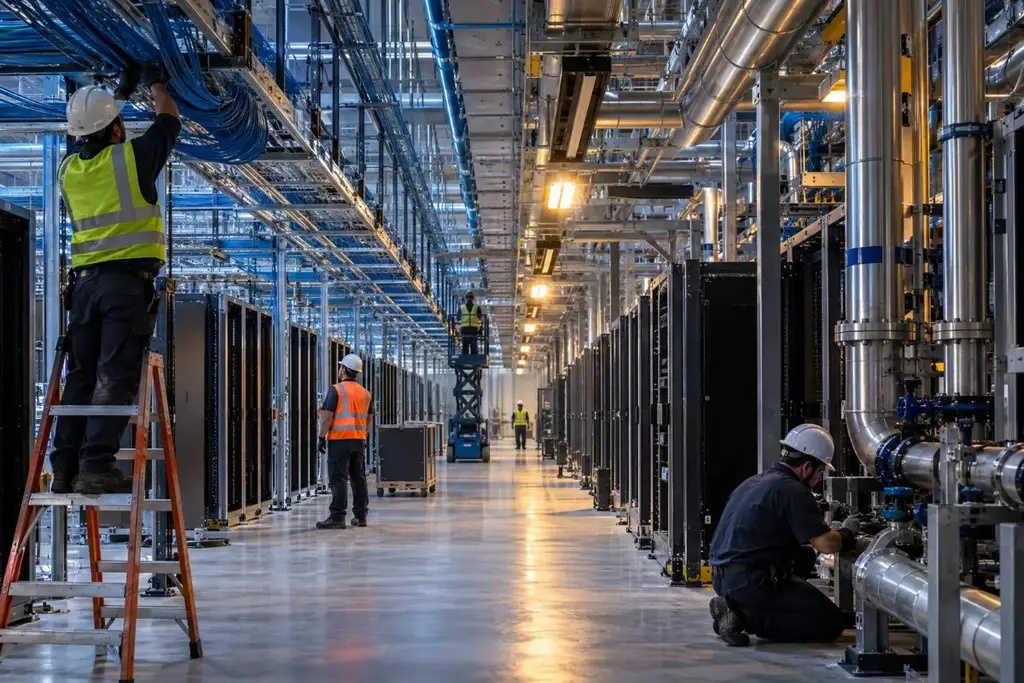
Il punto tecnico dell’accordo è che il nuovo acceleratore coreano Rebel R200 non nasce come alternativa isolata ai rack NVIDIA: dovrà entrare dentro la loro infrastruttura. Secondo il comunicato ufficiale di NVIDIA, Rebellions userà NVLink Fusion per collegare i propri NPU alla piattaforma della società americana e svilupperà sistemi rack-scale sulla base di NVIDIA MGX. SK Telecom, da parte sua, prevede di installarli nei propri data center AI e di collegarli ai suoi modelli proprietari, compreso A.X K2.
La firma è avvenuta al NVIDIA AI Day Seoul 2026, al COEX di Seoul, in forma di memorandum of understanding. La nota di SK Telecom chiarisce un dettaglio decisivo: non si tratta di una semplice fornitura di chip, ma di un progetto congiunto di sviluppo e verifica di un sistema integrato GPU-NPU. La ricostruzione pubblicata da Unite.AI ha evidenziato correttamente la distinzione centrale: l’annuncio definisce una roadmap industriale, non un’infrastruttura già in produzione.
Come funzionerà il rack misto GPU-NPU
La scelta architetturale dichiarata dalle tre aziende è la disaggregated inference, cioè la separazione delle fasi dell’inferenza generativa su processori diversi. Nel piano descritto da SK Telecom, le GPU NVIDIA gestiranno il prefill, la fase in cui il sistema analizza la richiesta dell’utente e costruisce lo stato iniziale del modello; gli NPU di Rebellions gestiranno invece il decode, la generazione sequenziale della risposta. La promessa è aumentare throughput ed efficienza energetica, ma le aziende non hanno ancora pubblicato benchmark indipendenti sul R200.
NVLink Fusion è il tassello che rende plausibile l’integrazione. La piattaforma, presentata da NVIDIA per collegare CPU, ASIC e XPU personalizzati alla propria infrastruttura AI, offre un’interconnessione ad alta banda e bassa latenza per sistemi eterogenei. Nella scheda tecnica del prodotto, NVIDIA descrive NVLink Fusion come tecnologia e IP per inserire XPU e CPU custom dentro una singola architettura rack-scale, con condivisione di alimentazione, raffreddamento, rete e gestione operativa. Per Rebellions significa non dover costruire da zero l’intero ecosistema server; per NVIDIA significa mantenere il proprio fabric come centro dell’AI factory anche quando entrano chip non NVIDIA.
La piattaforma MGX serve invece a standardizzare la parte fisica e industriale del rack: impronta a pavimento, distribuzione di potenza, raffreddamento, componenti e supply chain. Il comunicato NVIDIA-Rebellions-SKT specifica che l’ecosistema MGX darà a Rebellions accesso a produttori ODM e fornitori di componenti già allineati ai design NVIDIA. È una scorciatoia industriale importante: per un chip AI, la difficoltà non è soltanto il silicio, ma portarlo in rack densi, raffreddabili, gestibili e acquistabili da clienti enterprise.
Perché la Corea parla di AI sovrana
La dimensione politica è esplicita. Il progetto è sostenuto dal Ministry of Science and ICT della Corea del Sud, che vede l’accordo come un modo per far entrare gli NPU nazionali nel mercato dell’infrastruttura AI avanzata. Secondo Yonhap, il ministero vuole estendere collaborazioni simili oltre Rebellions ad altri sviluppatori coreani di NPU, con l’obiettivo di rafforzare l’ecosistema nazionale dei semiconduttori avanzati.
È una lettura meno nazionalista di quanto sembri. La sovranità, in questo caso, non significa uscire da NVIDIA. Significa usare il suo stack come piattaforma per inserire semiconduttori, modelli e servizi nazionali. Jensen Huang, fondatore e CEO di NVIDIA, ha presentato il progetto come un modo per trasformare lingua, cultura e competenze coreane in capacità AI; Sunghyun Park, cofondatore e CEO di Rebellions, ha parlato di una nuova fase per il silicio coreano collegato a tecnologie di sistema globali. Sono dichiarazioni aziendali, non prove di performance, ma spiegano l’equilibrio dell’accordo: autonomia a livello di chip e modelli, dipendenza controllata dall’infrastruttura NVIDIA.
SK Telecom è il soggetto che tiene insieme i tre piani: data center, modelli e servizi. Il gruppo non si limita a ospitare hardware: intende collegare i nuovi rack al proprio stack full-stack di AI sovrana, che comprende modelli proprietari e servizi pubblici. Nella nota aziendale, Jung Jai-hun, presidente e CEO di SK Telecom, cita esplicitamente A.X K2 e i servizi del progetto governativo AI for All come parte della strategia.
Il precedente: SK Telecom e il cloud AI con NVIDIA DSX
L’accordo sul R200 non nasce nel vuoto. Il 7 giugno 2026, NVIDIA e SK Telecom avevano annunciato un piano per costruire in Corea un AI Cloud su scala gigawatt basato su NVIDIA DSX, con la prima AI factory prevista online nel 2027. In quel progetto, SK Telecom sarebbe diventata anche NVIDIA Cloud Partner, usando l’infrastruttura per workload di training, inferenza e agentic AI destinati ad aziende e industrie coreane, secondo il comunicato NVIDIA del 7 giugno.
Il nuovo MOU aggiunge un livello diverso: non soltanto capacità GPU, ma anche integrazione di NPU coreani nell’AI factory. Questo sposta il tema dalla semplice disponibilità di calcolo alla composizione dell’infrastruttura. In pratica, SK Telecom sta costruendo una traiettoria in due tempi: prima data center AI su architettura NVIDIA, poi sistemi eterogenei in cui alcune fasi dell’inferenza possano essere accelerate da silicio nazionale.
Il calendario resta però prudente. NVIDIA indica il 2028 come data attesa per sistemi R200 pronti al deployment. Questo implica che il processore, il rack, il software di orchestrazione e l’integrazione con i modelli SKT devono ancora superare fasi di sviluppo e validazione. La stessa documentazione ufficiale contiene avvertenze sui rischi tipici degli annunci previsionali: sfide tecnologiche e operative, disponibilità delle risorse, accettazione del mercato e possibili differenze tra aspettative e risultati reali.
Cosa si sa del chip R200 e cosa no
Sul Rebel R200 i dati pubblici sono ancora limitati. NVIDIA lo descrive come NPU di prossima generazione ottimizzato per inferenza a bassa latenza ed efficienza energetica su modelli frontier, inclusi modelli mixture-of-experts multi-trillion-parameter. Non sono stati comunicati numero di chiplet, memoria, processo produttivo, consumi, benchmark MLPerf, prezzo o configurazione rack finale. Per questo, ogni confronto prestazionale con GPU NVIDIA o acceleratori concorrenti sarebbe prematuro.
Il contesto tecnico arriva però dalla famiglia precedente di Rebellions. La pagina prodotto di Rebel100 parla di un SoC a 4 chiplet omogenei basato su UCIe-Advanced, con 144 GB di memoria HBM3E e 4,8 TB/s di banda memoria. La società dichiara inoltre 1.024 TFLOPS in FP16 e 2.048 TFLOPS in FP8. Sono specifiche del Rebel100, non del R200, ma aiutano a capire il tipo di architettura da cui Rebellions sta evolvendo.
Rebel100: potenza di calcolo dichiarataValori in TFLOPS
- FP16
- FP8
Un approfondimento tecnico pubblicato da Rebellions Engineering spiega che il Rebel100 integra chiplet NPU, HBM3E e interconnessioni UCIe in un package pensato per l’inferenza. Nello stesso testo, la società descrive il successore Rebel100s con due chiplet I/O e connettività scale-up, segnale che la direzione industriale era già quella del rack. Il R200, nell’accordo con NVIDIA, sembra compiere il passo successivo: non solo scalare fra NPU Rebellions, ma entrare nel fabric NVLink di una AI factory NVIDIA.
A.X K2: il modello che dà senso all’infrastruttura
Il chip, da solo, non basta. SK Telecom vuole collegare i rack al proprio modello proprietario A.X K2, presentato il 29 luglio 2026. Secondo la newsroom internazionale di SK Telecom, A.X K2 ha 688 miliardi di parametri ed è disponibile su Hugging Face; segue A.X K1, che aveva 519 miliardi di parametri. SKT lo posiziona per casi d’uso industriali, pubblici, difesa, bio e produttività aziendale.
Crescita dei modelli A.X di SK TelecomValori in miliardi di parametri
- A.X K1
- A.X K2
Il A.X K2 Technical Report aggiunge elementi utili per capire perché l’inferenza diventa centrale. Il modello è addestrato nativamente a 128K token di contesto e, nei test riportati dagli autori, arriva a 94,6 di media su RULER fino a 256K token usando attenzione sparsa. Sono risultati dichiarati nel report tecnico di SKT e collaboratori, non una certificazione terza, ma indicano un carico computazionale coerente con l’esigenza di rack specializzati per serving su lunghi contesti.
Il progetto AI for All aumenta ulteriormente la pressione sull’inferenza. Il ministero coreano ha selezionato consorzi guidati da SK Telecom, KT e Kakao per sviluppare servizi AI accessibili alla popolazione; secondo Yonhap, i tre gruppi riceveranno complessivamente 512 GPU NVIDIA B200 e dovranno usare modelli AI domestici per almeno il 50% del sistema. In questa cornice, un’infrastruttura che combina GPU NVIDIA e NPU coreani serve a sostenere servizi nazionali su larga scala, non solo demo di laboratorio.
La strategia di NVIDIA: aprire senza perdere il controllo
NVLink Fusion è spesso presentato come apertura dell’ecosistema NVIDIA, ma è anche una mossa difensiva. La società consente a hyperscaler, chipmaker e paesi con ambizioni sovrane di collegare chip custom alla propria architettura, evitando che costruiscano interi stack alternativi. Nel lancio di NVLink Fusion, NVIDIA aveva citato partner come MediaTek, Marvell, Alchip, Astera Labs, Synopsys, Cadence, Fujitsu e Qualcomm. L’ingresso di Rebellions porta lo stesso schema in un progetto nazionale di AI sovrana.
Il messaggio ai governi è chiaro: si può costruire infrastruttura nazionale senza rinunciare alla compatibilità con lo stack NVIDIA. Il messaggio ai concorrenti è più duro: anche quando un acceleratore custom entra nel data center, rete, rack, software operativo e supply chain possono restare dentro l’orbita NVIDIA. Per questo l’accordo coreano non va letto come una sconfitta per le GPU americane. Al contrario, le GPU rimangono nella fase di prefill e nella piattaforma complessiva, mentre gli NPU Rebellions ricevono un ruolo specializzato nella fase di decode.
Per i concorrenti coreani, il rischio è di restare fuori dalla prima corsia. Il ministero ha già indicato l’intenzione di estendere il modello ad altri sviluppatori nazionali di NPU; MoneyToday segnala che al forum parallelo con NVIDIA hanno partecipato startup coreane attive in modelli, semiconduttori e physical AI, tra cui Upstage, TwelveLabs, FuriosaAI, DeepX e Rebellions. La differenza è che Rebellions ha ora un progetto nominativo con SKT e NVIDIA su R200.
I punti aperti: benchmark, software e supply chain
Il primo punto aperto è la misurazione. Le aziende parlano di miglioramento di throughput ed efficienza energetica, ma non hanno pubblicato dati su token al secondo, latenza, consumo per token o costo totale per rack del sistema GPU-NPU. Senza benchmark riproducibili su modelli come A.X K2 e senza confronto con rack solo GPU, l’efficienza resta un obiettivo dichiarato.
Il secondo riguarda il software. Separare prefill e decode richiede orchestrazione fine: scheduling, gestione della memoria KV, trasferimento rapido dello stato tra processori, resilienza, bilanciamento dei carichi e integrazione con framework di serving. NVIDIA sta già lavorando sul livello software con Dynamo: il blog NVIDIA dell’8 novembre 2026 indica ricette ottimizzate per A.X K2 di SK Telecom, K-EXAONE 2.0 di LG AI Research, Solar Open 2 di Upstage e Motif-3 di Motif Technologies. Anche qui, però, le ricette software disponibili oggi non equivalgono ancora a un rack R200 operativo.
Il terzo limite è industriale. Un chip AI competitivo richiede capacità avanzata di packaging, memoria HBM, interconnessione, alimentazione e raffreddamento. La Corea del Sud ha punti di forza evidenti nella memoria e nella manifattura elettronica, ma l’integrazione in una AI factory resta una prova complessa. Il fatto che il deployment sia indicato per il 2028 segnala che le aziende stanno comprando tempo per validare sia il silicio sia il sistema.
Oltre la notizia
L’accordo premia chi controlla uno strato dell’infrastruttura difficile da sostituire. NVIDIA conserva il ruolo di piattaforma: anche aprendo NVLink Fusion a chip esterni, mantiene il rack, il fabric, il software operativo e una parte cruciale della catena di fornitura. Rebellions guadagna una via credibile per trasformare un NPU nazionale in un prodotto da data center, evitando di dover convincere clienti e fornitori a scommettere su uno stack completamente separato. SK Telecom ottiene una narrazione industriale forte: può presentarsi come operatore di AI sovrana full-stack, dal data center ai modelli fino ai servizi pubblici.
Chi rischia di perdere terreno sono i produttori di acceleratori che non riescono a entrare nei grandi ecosistemi di interconnessione. Per le startup europee e italiane, il segnale è concreto: la sovranità AI non si gioca solo sul modello linguistico o sul cloud locale, ma anche sulla possibilità di integrare chip specializzati in piattaforme già adottate dai grandi data center. Nei prossimi mesi andranno osservati tre segnali: specifiche pubbliche del R200, benchmark su A.X K2 o modelli equivalenti, e primi dettagli sul rack MGX GPU-NPU che SK Telecom dovrà validare prima del 2028.
Domande e risposte
Che cosa hanno annunciato NVIDIA, Rebellions e SK Telecom il 9 novembre 2026?
Le tre aziende hanno firmato a Seoul un MOU per sviluppare un sistema AI eterogeneo che colleghi GPU NVIDIA e NPU Rebellions Rebel R200 tramite NVLink Fusion. SK Telecom prevede di usare questi sistemi nei propri data center AI, con deployment atteso nel 2028.
A cosa serve NVLink Fusion nel progetto con Rebellions R200?
NVLink Fusion permette a processori custom, come NPU o ASIC di terze parti, di entrare nell’infrastruttura rack-scale NVIDIA. Nel progetto coreano servirà a collegare gli R200 alla piattaforma NVIDIA MGX, rendendo possibile un sistema misto GPU-NPU per inferenza AI.
Perché SK Telecom vuole separare prefill e decode nell’inferenza AI?
Il piano prevede di usare GPU NVIDIA per il prefill, più pesante dal punto di vista computazionale, e NPU Rebellions per il decode, dove contano memoria, latenza ed efficienza. Le aziende puntano a migliorare throughput e consumo per token, ma non hanno ancora pubblicato benchmark indipendenti.
Quando saranno disponibili i sistemi Rebellions R200 con NVLink Fusion?
NVIDIA indica il 2028 come data prevista per sistemi R200 pronti al deployment. Prima servono sviluppo del processore, integrazione con NVLink Fusion e MGX, validazione nei data center SK Telecom e prove sui modelli proprietari come A.X K2.
Il progetto coreano riduce la dipendenza da NVIDIA?
Solo in parte. Rebellions porta silicio coreano nell’infrastruttura, e SK Telecom collega modelli e servizi nazionali. Ma il rack, il fabric NVLink Fusion e una parte importante dello stack restano NVIDIA. È una strategia di sovranità integrata, non una sostituzione completa.
Fonti verificate
Francesco Giuliani
Fondatore e direttore editoriale de Il Modello
Francesco Giuliani è un imprenditore, sviluppatore e innovatore italiano attivo nel settore dell'intelligenza artificiale, dell'editoria digitale e della comunicazione. È fondatore e CEO di Faraday AI Studio, agenzia italiana specializzata in soluzioni AI per imprese, reputazione digitale e difesa.
Tutti gli articoli di Francesco⚙️ Sala macchine
Qui i lettori non commentano: contribuiscono. Nessun contributo ancora su questo articolo — la discussione la apri tu.
Carico…
Carico i contributi…
Continua a leggere

Amazon accumula rack Nvidia GB300: il collo di bottiglia è la rete elettrica
Le email interne citate dalla stampa mostrano un cambio di strategia: AWS accetta rack GB300 prima dell’installazione finale. I conti Amazon confermano la pressione del CapEx, mentre il limite vero diventa la rete elettrica.

TOPC mette 192 GB sul tavolo: l’AI locale costa almeno 6.499 dollari
Il mini PC cinese punta tutto sui 192 GB di memoria unificata per modelli locali di grandi dimensioni, ma prezzo reale in Italia, assistenza e maturità software restano i nodi decisivi.

NVIDIA porta i modelli aperti nella PA europea con 2 dataset da 1 milione
La strategia europea di NVIDIA punta su agenti governati, dataset sintetici e infrastrutture controllate. Il nodo aperto è quanto questa sovranità resti dipendente dallo stack tecnico del fornitore americano.
