ChatGPT, chi può leggere le conversazioni? Cos’è Project Lily e come proteggere le proprie chat
Un’inchiesta ha rivelato che centinaia di collaboratori esterni leggono conversazioni selezionate di ChatGPT per valutarne le risposte. Il programma interno, chiamato Project Lily, usa filtri per rimuovere dati identificativi, ma non è una garanzia assoluta.

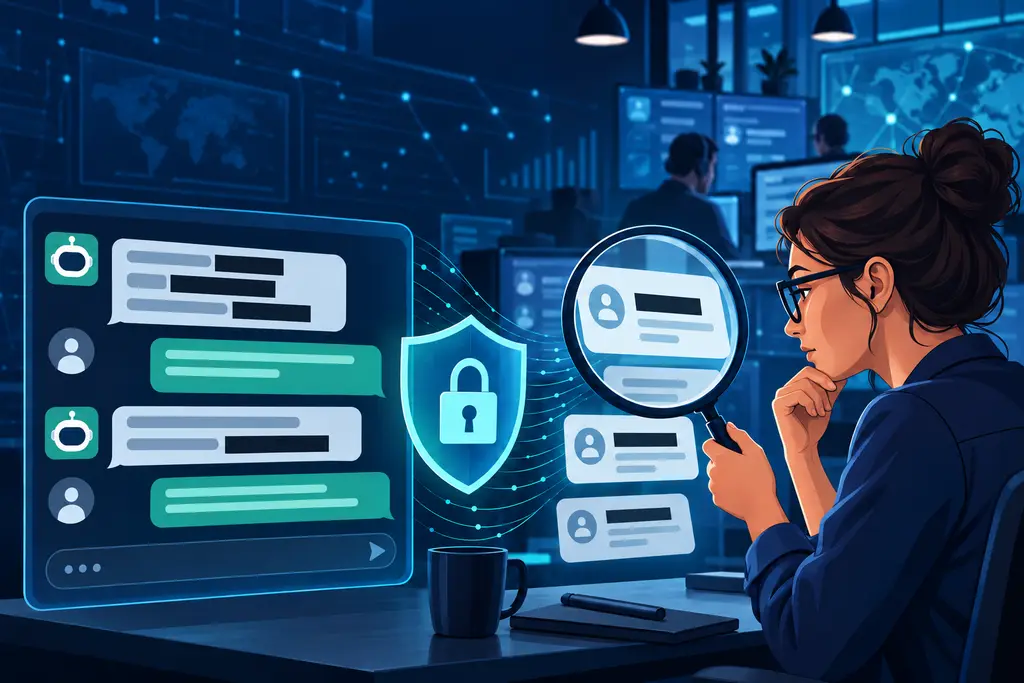
Project Lily è il nome in codice di un programma di revisione umana emerso da un’inchiesta di 404 Media, pubblicata il 14 settembre 2026. Secondo i documenti interni, i canali Slack, le istruzioni operative e i prompt reali visionati dalla testata, OpenAI affida a centinaia di collaboratori esterni l’analisi di una parte delle conversazioni degli utenti di ChatGPT: l’obiettivo è giudicare la qualità delle risposte del modello e fornire segnali utili al suo miglioramento. La ricostruzione è stata ripresa in Italia da IlSoftware.it, che chiarisce un punto essenziale: non ogni chat viene letta da una persona, ma alcuni dialoghi selezionati possono entrare in una pipeline di valutazione.
Il nome Project Lily non compare, al momento, nella documentazione pubblica di OpenAI: proviene dall’inchiesta di 404 Media. L’azienda, però, dichiara pubblicamente che per i servizi rivolti ai singoli utenti può usare i contenuti condivisi per addestrare e migliorare i modelli, salvo opposizione dell’utente. In altre parole, la novità non è l’esistenza teorica dell’uso delle chat per il training, già previsto dalle policy; è il livello di dettaglio sul lavoro umano che accompagna quella fase.
Chi sono i revisori e che cosa vedono
Le persone che possono leggere le conversazioni nell’ambito di Project Lily non sarebbero dipendenti ordinari di OpenAI incaricati di assistenza clienti. L’inchiesta parla di contractor, cioè lavoratori esterni assunti attraverso società specializzate. Secondo ricostruzioni basate sulle istruzioni trapelate, il reclutamento passa anche da Crossing Hurdles, mentre i pagamenti vengono gestiti tramite Mercor; la remunerazione indicata è superiore a 50 dollari l’ora. Sono dettagli giornalistici, non confermati in modo autonomo da OpenAI, e vanno quindi letti come tali. Tom’s Guide, che ha esaminato la ricostruzione, riferisce anche che i valutatori ricevono il prompt, riassumono l’intento dell’utente e confrontano quattro risposte candidate su una scala da 1 a 7.
Il loro compito non è soltanto segnalare testi vietati o pericolosi. Le linee operative descritte nell’inchiesta riguardano qualità, stile e affidabilità: individuare risposte troppo compiacenti, evitare che il chatbot si attribuisca esperienze umane reali, limitare formule stereotipate e correggere risposte poco utili. È una forma di human feedback, il contributo umano con cui si costruiscono esempi e preferenze per il successivo addestramento del modello. In questo schema il revisore può avere bisogno del contesto della conversazione, non della sola domanda finale: è il motivo per cui, secondo i documenti citati da 404 Media, possono comparire intere sequenze di dialogo.
OpenAI sostiene di non mostrare ai revisori il nome utente dell’account e di applicare strumenti automatici per ridurre le informazioni identificative. Questo non equivale però a rendere innocuo ogni contenuto. Una chat può contenere nomi, indirizzi, dettagli sanitari, condizioni familiari, bozze contrattuali, codice proprietario, numeri di telefono o elementi sufficienti a ricostruire l’identità di una persona anche senza vedere l’intestazione dell’account. L’inchiesta segnala precisamente questo limite: il filtro è previsto, ma dati delicati possono passare comunque.
Tre tipi diversi di accesso umano alle chat
Project Lily va distinto da altre circostanze in cui una conversazione può essere sottoposta a controllo umano. La prima è la valutazione per migliorare il modello, alla quale appartiene il programma rivelato dall’inchiesta. La seconda riguarda la sicurezza: OpenAI spiega di usare classificatori automatici e personale addestrato per esaminare contenuti segnalati o potenzialmente in violazione delle policy. In caso di rischi concreti di violenza o abuso, i revisori possono analizzare la conversazione nel suo contesto e l’azienda può limitare o chiudere un account. La pagina di trasparenza di OpenAI conferma la combinazione di rilevamento automatico e revisione umana dei contenuti segnalati.
La terza categoria è l’accesso necessario a fornire il servizio: supporto tecnico, indagini su abusi, obblighi legali e attività di sicurezza. Nelle offerte professionali, OpenAI precisa che le conversazioni conservate sui propri sistemi possono essere accessibili a dipendenti autorizzati che ne abbiano necessità e a contractor specializzati vincolati da obblighi di riservatezza e sicurezza. Il limite dichiarato per questi ultimi, nei piani aziendali, è la verifica di abusi e usi impropri. L’informativa Enterprise Privacy chiarisce quindi che “nessun training di default” non significa “nessun possibile accesso umano in assoluto”.
Per gli utenti consumer, la differenza più importante è tra il consenso al miglioramento del modello e i controlli di sicurezza. Disattivare l’uso delle chat per l’addestramento riduce l’esposizione al tipo di revisione qualitativa descritto da Project Lily, ma non impedisce eventuali verifiche circoscritte per contrastare abusi, rispondere a obblighi di legge o proteggere la piattaforma. Anche DDay.it richiama questa distinzione: l’opt-out dal training agisce sulle nuove chat destinate al miglioramento, non annulla ogni trattamento previsto dalle condizioni di servizio.
Il Privacy Filter: utile, ma non è una garanzia assoluta
Il sistema che dovrebbe intervenire prima della revisione si chiama OpenAI Privacy Filter. OpenAI lo ha presentato il 22 aprile 2026 come modello open-weight per individuare e mascherare informazioni personali identificative, dalle e-mail ai numeri di conto, dagli indirizzi ai segreti tecnici come password e chiavi API. L’azienda afferma di utilizzarne una versione interna su dataset pubblici e sulle conversazioni degli utenti che mantengono attiva l’opzione Improve the model for everyone. La documentazione di OpenAI conferma che il filtro opera in più fasi del processo di training.
Nei test pubblicati dalla società, Privacy Filter ottiene un punteggio F1 del 96% sul benchmark PII-Masking-300k, che sale al 97,43% nella versione corretta del dataset. Sono risultati elevati, ma descrivono un benchmark e non certificano che ogni dato sensibile venga rimosso da ogni conversazione reale, in tutte le lingue e in ogni contesto. Proprio questa distanza tra prestazione media e casi concreti è il punto sollevato da Project Lily: un’informazione personale narrata in modo indiretto, contestuale o incompleto può essere più difficile da intercettare rispetto a un indirizzo e-mail o a una sequenza numerica. OpenAI stessa presenta il filtro come una salvaguardia per ridurre la quantità di dati personali, non come un meccanismo infallibile.
Privacy Filter: punteggio F1 dichiarato
- PII-Masking-300k
- Versione corretta del benchmark
L’elemento più rilevante per l’utente è che il filtraggio avviene dopo che il contenuto è stato inviato a OpenAI. Non sostituisce quindi la prudenza a monte. Un curriculum con dati personali, una cartella clinica, una bozza di acquisizione aziendale, un documento non ancora pubblicato o il codice sorgente di un prodotto non dovrebbero essere trattati come testo neutro solo perché vengono incollati in una normale chat gratuita o a pagamento per consumatori.
Come impedire l’uso delle nuove chat per il training
Per un account personale, il controllo da verificare è Improve the model for everyone. Da ChatGPT sul web occorre aprire il profilo, selezionare Settings, poi Data Controls, e disattivare l’interruttore; su mobile il percorso passa dal menu laterale, dal profilo e da Data Controls. L’impostazione si sincronizza sull’intero account. OpenAI specifica che, una volta effettuata la scelta, le nuove conversazioni restano visibili nella cronologia ma non vengono utilizzate per addestrare ChatGPT. Dal 13 settembre 2026, la stessa impostazione vale anche per i task di Codex negli account personali. La FAQ ufficiale sui controlli dei dati descrive tutti i passaggi.
La scelta non opera retroattivamente sui contenuti che fossero già stati usati e disassociati dall’account nel processo di miglioramento. Per rimuovere una conversazione ordinaria dalla propria cronologia bisogna cancellarla: secondo l’informativa europea di OpenAI, i dati eliminati vengono rimossi dai sistemi entro 30 giorni, salvo esigenze di sicurezza, prevenzione delle frodi, obblighi legali oppure casi in cui i contenuti siano già stati de-identificati e separati dall’account. L’opt-out, dunque, è una protezione per il futuro; la cancellazione serve a gestire ciò che è stato già salvato.
La soluzione più restrittiva disponibile nell’interfaccia consumer è la Temporary Chat. Non compare nella cronologia, non crea nuovi ricordi e non viene usata per migliorare i modelli finché rimane temporanea. OpenAI conserva comunque una copia fino a 30 giorni per ragioni di sicurezza e precisa che tali conversazioni possono essere riviste esclusivamente per monitorare abusi. C’è inoltre una distinzione spesso trascurata: una chat temporanea personalizzata può usare ricordi esistenti, istruzioni personalizzate e plugin; per una sessione davvero separata dal profilo occorre scegliere l’opzione non personalizzata. La FAQ sulle chat temporanee dettaglia queste condizioni.
Che cosa cambia per professionisti e aziende italiane
Per studi professionali, imprese, pubbliche amministrazioni e sviluppatori, la conclusione pratica non è abbandonare ogni assistente generativo, ma separare con rigore gli ambienti. I piani ChatGPT Business, Enterprise, Edu e la piattaforma API non usano input e output per addestrare i modelli per impostazione predefinita, a meno di una scelta esplicita dell’organizzazione. Questo li rende diversi dall’uso di un account personale Free, Plus o Pro, dove l’utente deve verificare personalmente l’opt-out. La policy sul miglioramento delle prestazioni del modello conferma la distinzione tra servizi consumer e business.
Non basta però acquistare un piano aziendale per risolvere ogni profilo di rischio. Gli amministratori di uno spazio di lavoro possono gestire, esportare, visualizzare e cancellare le conversazioni degli utenti del workspace. Per le API, OpenAI dichiara inoltre una conservazione ordinaria degli input e degli output fino a 30 giorni per erogare il servizio e rilevare abusi, con possibilità di zero data retention per endpoint e casi d’uso idonei. Prima di caricare dati personali o documenti riservati, un’organizzazione dovrebbe quindi definire ruoli, tempi di conservazione, istruzioni ai dipendenti e una valutazione del fornitore coerente con il proprio trattamento dati.
In Italia il tema della trasparenza ha anche un precedente rilevante. Nel dicembre 2024 il Garante per la protezione dei dati personali aveva chiuso l’istruttoria su ChatGPT con una sanzione da 15 milioni di euro e una campagna informativa di sei mesi; tuttavia, il provvedimento n. 755 del 2 novembre 2024 è stato rimosso temporaneamente dal sito dell’Autorità dopo che il 18 marzo 2026 il Tribunale di Roma ha accolto l’opposizione di OpenAI. Non è quindi corretto descrivere oggi quella sanzione come definitiva ed efficace. Rimane però il nucleo del dibattito: informativa comprensibile, base giuridica, minimizzazione e possibilità concreta per gli interessati di esercitare i propri diritti. Il Garante ricostruisce sia il provvedimento sia il successivo esito giudiziario.
Il confronto con Gemini: una trasparenza più esplicita
La revisione umana non è un’eccezione limitata a OpenAI. Google, nella sua informativa italiana per Gemini, dichiara apertamente che una parte delle chat può essere esaminata da revisori umani, compresi fornitori di servizi addestrati, per migliorare le risposte, contrastare contenuti dannosi e applicare le regole del servizio. Google afferma di scollegare le conversazioni dall’account prima di inviarle ai fornitori e avverte esplicitamente di non inserire informazioni riservate che non si vorrebbero far vedere a un revisore. Il Privacy Hub di Gemini specifica anche che le chat già esaminate possono essere conservate fino a tre anni.
La differenza non è che Gemini renda automaticamente private tutte le conversazioni: anche Google prevede il controllo umano per sicurezza quando l’utente disattiva il salvataggio dell’attività o usa le chat temporanee. La differenza è nella formulazione. Google esplicita nella pagina privacy l’esistenza dei revisori e l’invito a non condividere dati confidenziali; nel caso di Project Lily, l’attenzione nasce invece da documenti interni che hanno reso visibile una struttura di valutazione più ampia e sistematica di quanto molti utenti potessero immaginare.
Domande e risposte
Chi può leggere le conversazioni di ChatGPT con Project Lily?
Secondo l’inchiesta di 404 Media del 14 settembre 2026, possono leggerle centinaia di collaboratori esterni incaricati di valutare prompt e risposte selezionati. Non vedrebbero il nome dell’account, ma potrebbero ricevere il contesto completo della chat dopo il passaggio attraverso filtri automatici per i dati identificativi.
Come faccio a impedire che ChatGPT usi le mie chat per addestrare l’IA?
Accedi a ChatGPT, apri Impostazioni, vai in Controllo dei dati e disattiva “Migliora il modello per tutti”. La modifica vale per l’intero account e, secondo la FAQ aggiornata il 13 settembre 2026, impedisce che le nuove chat e i nuovi task di Codex personali siano usati per addestrare i modelli.
La chat temporanea di ChatGPT è davvero privata?
No, non equivale a una conversazione che nessuno può mai controllare. Una Temporary Chat non finisce nella cronologia, non crea memorie e non viene usata per il training, ma OpenAI può conservarne una copia fino a 30 giorni. In quel periodo può essere esaminata per il monitoraggio di abusi e sicurezza.
ChatGPT Enterprise e API usano i dati aziendali per addestrare OpenAI?
Per impostazione predefinita, OpenAI dichiara di non addestrare i modelli con input e output di ChatGPT Business, Enterprise, Edu e API. Restano però possibili accessi limitati per supporto tecnico, indagini su abusi e conformità legale. Per le API, la conservazione standard indicata è fino a 30 giorni, salvo opzioni idonee di zero data retention.
Project Lily è un promemoria utile: l’intelligenza artificiale non migliora soltanto grazie a chip, dataset e algoritmi, ma anche attraverso il giudizio di persone che valutano risultati reali. Questo lavoro è necessario per rendere i modelli meno compiacenti, più affidabili e più sicuri. Proprio per questo deve essere spiegato con precisione, non nascosto dietro formule generiche.
La strada migliore per OpenAI è rendere visibili nell’interfaccia, con linguaggio semplice, tre elementi: quando una chat può contribuire al training, quali categorie di revisori possono accedervi e quali dati vengono trattenuti dopo la cancellazione. Per utenti e aziende l’opportunità è costruire una cultura d’uso più matura: scegliere il piano adatto, disattivare il training quando serve e trattare i prompt riservati con la stessa attenzione riservata a e-mail, cloud e documenti condivisi.
Fonti verificate
- IlSoftware.it
- 404 Media
- Tom’s Guide
- La pagina di trasparenza di OpenAI
- L’informativa Enterprise Privacy
- DDay.it
- La documentazione di OpenAI
- OpenAI stessa
- La FAQ ufficiale sui controlli dei dati
- l’informativa europea di OpenAI
- La FAQ sulle chat temporanee
- La policy sul miglioramento delle prestazioni del modello
- Il Garante
- Il Privacy Hub di Gemini
Francesco Giuliani
Francesco Giuliani è un imprenditore, sviluppatore e innovatore italiano attivo nel settore dell'intelligenza artificiale, dell'editoria digitale e della comunicazione. È fondatore e CEO di Faraday AI Studio, agenzia italiana specializzata in soluzioni AI per imprese, reputazione digitale e difesa.
⚙️ Sala macchine
Qui i lettori non commentano: contribuiscono. Nessun contributo ancora su questo articolo — la discussione la apri tu.
Carico…
Carico i contributi…
Continua a leggere

Sovranità digitale: come riprendere il controllo di software, dati, cloud e identità
La sovranità digitale è la capacità di scegliere alternative tecnologiche libere da dipendenze eccessive. Non significa rinunciare ai servizi commerciali, ma riprendere il controllo sui dati, il software e le infrastrutture.

Meta One, abbonamenti da 2,49 euro per WhatsApp, Instagram e Facebook: prezzi e funzioni
Meta lancia Meta One, un ecosistema di abbonamenti per le sue app che unisce funzioni professionali e avanzate capacità di intelligenza artificiale. Ecco i dettagli per utenti, creator e aziende.

UE, verso il Kids Act: sotto i 15 anni social e chatbot IA solo con il consenso dei genitori
L'Unione Europea si prepara a introdurre il Kids Act, una proposta di legge che regolamenterà l'accesso dei minori di 15 anni a social network, chatbot e piattaforme di IA, richiedendo il consenso dei genitori.

OpenAI compra Glass Imaging: la tecnologia promette foto da reflex con sensori da smartphone
OpenAI ha acquisito Glass Imaging per oltre 300 milioni di dollari. La startup, specializzata in fotografia computazionale, promette di migliorare la qualità delle immagini da sensori compatti, integrando una visione cruciale per futuri dispositivi AI.