Google lancia Gemini 3.8 Flash: l'IA per agenti e coding punta su costi ridotti e ragionamento avanzato
Google ha rilasciato Gemini 3.8 Flash, il suo nuovo modello AI che punta su costi ridotti e ragionamento avanzato per agenti e sviluppo software, introducendo anche la variante Cyber per la sicurezza.

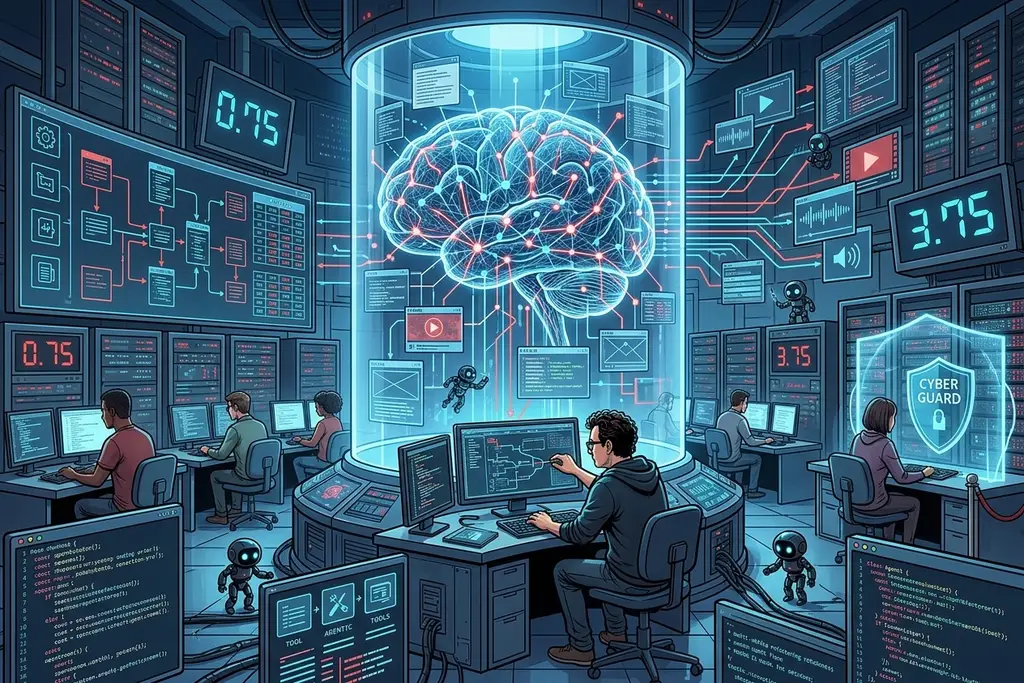
Il lancio riguarda due modelli distinti ma strettamente collegati. Nell’annuncio ufficiale, Google presenta Gemini 3.8 Flash come il suo modello Flash più avanzato per coding, agenti autonomi e ragionamento multi-passaggio; Gemini 3.8 Flash Cyber, invece, è la versione specializzata per individuare vulnerabilità e generare patch. Google DeepMind chiarisce che i due sistemi condividono la stessa base di intelligenza, ma sono pensati per ambienti di distribuzione diversi.
La versione per sviluppatori è già in disponibilità generale. Nella documentazione della Gemini API, il modello stabile è indicato come gemini-3.8-flash, con livello di ragionamento predefinito medium, finestra di contesto da 1 milione di token e output massimo da 64K token. Supporta input testuali, immagini, audio, video e PDF, oltre agli strumenti integrati usati nei flussi agentici.
La novità non è solo prestazionale. Google lo descrive come il terzo rilascio Flash in sei settimane, dopo 3.7 Flash arrivato tre settimane prima. La linea Flash, nata per velocità e costo contenuto, viene ora spinta verso attività più lunghe: refactoring su più file, uso iterativo degli strumenti, ricerca su documenti estesi e procedure aziendali che richiedono più passaggi invece di una singola risposta.
Il prezzo è una parte centrale della strategia. Google indica per Gemini 3.8 Flash una tariffa introduttiva fino al 31 dicembre 2026: 0,75 dollari per 1 milione di token in input e 3,75 dollari per 1 milione di token in output, gli stessi livelli comunicati per 3.7 Flash. È un listino aggressivo, soprattutto per chi costruisce agenti che devono eseguire molte chiamate consecutive.
Il listino, però, non racconta tutto il costo operativo. Nell’annuncio Google spiega che il modello, sui problemi complessi, tende a eseguire più passaggi di ragionamento e a richiamare strumenti in modo iterativo; per questo può consumare più token. La ricostruzione di InfoData sintetizza bene il punto: il prezzo nominale resta basso, ma il costo effettivo per incarico va misurato sul carico reale, non soltanto sulla tariffa per milione di token.
Una conferma arriva anche dall’analisi indipendente di Artificial Analysis, secondo cui Gemini 3.8 Flash, a ragionamento alto, migliora l’indice di intelligenza rispetto a 3.7 Flash ma arriva a costare circa il 40% in più per task, per via di un incremento del 30% nei token di output medi e di più turni nelle valutazioni agentiche.
Prestazioni: dove avanza e dove no
Sui benchmark pubblicati da Google, Gemini 3.8 Flash viene presentato come un netto passo avanti rispetto a 3.7 Flash in ingegneria software, compiti agentici e domini professionali. Il dato esplicito riportato nel comunicato è 54,9% su HLE-Verified, metrica usata per valutare ragionamento multi-passaggio su discipline STEM, umanistiche e professionali.
InfoData aggiunge altri numeri utili alla lettura: circa 73,8% su DeepSWE v1.1 e 61,4% su Vals Finance Agent v2. La stessa analisi segnala però che il modello non domina ogni scenario: su Terminal-Bench 4.0 viene indicato un risultato di 19,1%, lontano dai migliori modelli generalisti citati nel confronto. È il promemoria più importante: i benchmark servono, ma non sostituiscono test sui propri dati, sul proprio codice e sui vincoli di latenza reali.
Gemini 3.8 Flash sui benchmark
- DeepSWE v1.1
- Vals Finance Agent v2
- HLE-Verified
- Terminal-Bench 4.0
La pagina di DeepMind dedicata a Gemini Flash mostra anche esempi dimostrativi orientati agli agenti: un gioco 3D creato in Google Antigravity da un prompt con istruzioni iterative e una versione in stile DOS di Google Maps funzionante con luoghi, indicazioni e Street View. Sono demo, non prove scientifiche, ma indicano la direzione: meno risposte isolate, più costruzione progressiva di prodotti software o workflow completi.
La variante Cyber resta chiusa
Gemini 3.8 Flash Cyber segue una logica diversa dalla versione pubblica. Il Fairwind Program offre accesso anticipato a difensori considerati prioritari, come governi, sanità, telecomunicazioni e operatori di infrastrutture critiche. La scelta riflette la natura duale di questi strumenti: la capacità di trovare vulnerabilità può migliorare la difesa, ma nelle mani sbagliate può diventare un vantaggio offensivo.
In un post separato sul programma, Google spiega che Fairwind combina Gemini 3.8 Flash Cyber con CodeMender, un sistema pensato per trovare, verificare e correggere vulnerabilità su scala agentica. Non è quindi un normale endpoint pubblico della Gemini API: l’accesso passa da una selezione istituzionale e da vincoli di governance.
Le prestazioni dichiarate da DeepMind sono rilevanti. La scheda di Gemini 3.8 Flash Cyber afferma che il modello può navigare codebase in 20 linguaggi, supera 3.5 Flash Cyber e modelli più grandi su CyberGym, raggiunge oltre il 70% in un benchmark interno di scoperta vulnerabilità e arriva a 47,2% contro 47,8% di Fable 5 su CWE-Bench, con un costo dichiarato molto più basso.
La competizione si sposta sul costo per lavoro riuscito
Il confronto con i concorrenti mette in evidenza la pressione sui prezzi. La documentazione di OpenAI indica per GPT-6 Astra 10 dollari per milione di token in input e 50 dollari in output. Gemini 3.8 Flash non va confrontato solo su questa distanza di listino, ma sul costo per completare correttamente un compito: un modello economico che riprova molte volte può ridurre o aumentare la spesa, a seconda del workflow.
Anche Claude Fable 5.1 si colloca nella fascia alta, con prezzo di 10 dollari per input e 50 dollari per output per milione di token. La differenza è che Google sta portando capacità da modello avanzato dentro una fascia più economica. Per le imprese, questo può rendere sostenibili agenti interni che fino a pochi mesi fa sarebbero stati troppo costosi da far girare su larga scala.
Prezzo per 1 milione di token
InputOutput
- Gemini 3.8 Flash
- GPT-6 Astra
- Claude Fable 5.1
Per gli sviluppatori la raccomandazione pratica è semplice: non migrare alla cieca. Gemini 3.8 Flash va provato sui task difficili, dove una maggiore accuratezza può ripagare il consumo extra di token; per pipeline ad alto volume, risposte brevi o processi già stabili, 3.7 Flash può restare una scelta efficiente. La documentazione consente di regolare i livelli di ragionamento, e questo diventa un controllo economico oltre che tecnico.
Per le aziende italiane il punto più interessante è l’automazione di processi reali: analisi documentale, supporto a sviluppatori, revisione di contratti, ricerca su basi di conoscenza interne e orchestrazione di strumenti. La finestra di contesto ampia aiuta, ma non elimina il lavoro di integrazione. Servono logging dei costi, test di qualità, controlli sui dati sensibili e fallback chiari quando l’agente non è abbastanza affidabile.
Domande e risposte
Quando è uscito Gemini 3.8 Flash e dove si può usare?
Gemini 3.8 Flash è stato rilasciato in disponibilità generale il 2 settembre 2026. Google lo distribuisce tramite Gemini API, Google AI Studio, Gemini app, AI Mode, Gemini Enterprise Agent Platform e Google Antigravity. Il modello stabile per gli sviluppatori è gemini-3.8-flash, con livello di ragionamento predefinito medium.
Quanto costa Gemini 3.8 Flash nella Gemini API?
Fino al 31 dicembre 2026, il prezzo introduttivo indicato da Google è 0,75 dollari per 1 milione di token in input e 3,75 dollari per 1 milione di token in output. Il costo reale di un task può salire se il modello usa più passaggi di ragionamento o più chiamate agli strumenti.
Gemini 3.8 Flash Cyber è disponibile per tutti?
No. Dal 2 settembre 2026, Gemini 3.8 Flash Cyber è accessibile solo tramite Fairwind Program per difensori selezionati. Google cita governi, sanità, telecomunicazioni e infrastrutture critiche; DeepMind parla di analisi su codebase in 20 linguaggi. La restrizione serve a ridurre i rischi di uso offensivo.
Gemini 3.8 Flash è meglio di GPT-6 Astra e Claude Fable 5.1?
Non in modo assoluto. Nei dati raccolti il 12 settembre 2026, InfoData riporta Gemini vicino ai migliori su DeepSWE v1.1, ma più debole su Terminal-Bench 4.0. Il vantaggio più chiaro è economico: il prezzo API di Google è 0,75/3,75 dollari per milione di token, sotto i listini top di OpenAI e Anthropic.
Per quali aziende ha senso provare Gemini 3.8 Flash?
Ha senso per team che nel 2026 usano agenti per refactoring, analisi di documenti lunghi, ricerca interna o orchestrazione di strumenti. La finestra da 1 milione di token e l’output da 64K aiutano nei flussi complessi; per attività ripetitive e sensibili alla latenza può bastare 3.7 Flash.
Vedo in Gemini 3.8 Flash un segnale molto concreto: l’intelligenza utile si sta spostando verso modelli che non devono soltanto rispondere bene, ma lavorare abbastanza a lungo da completare un incarico. È qui che si aprono opportunità importanti per imprese, sviluppatori e pubbliche amministrazioni, purché si misuri il risultato finale e non il singolo prompt.
La scelta di separare la variante Cyber e distribuirla con controlli più stretti mi sembra corretta. Non rallenta l’innovazione: la rende più credibile. Se Google riuscirà a mantenere prezzi competitivi, trasparenza sui benchmark e strumenti migliori per controllare il consumo di token, i modelli Flash potranno diventare una piattaforma pratica per automatizzare lavoro qualificato senza trasformare ogni progetto AI in un esperimento fuori budget.
Fonti verificate
Francesco Giuliani
Francesco Giuliani è un imprenditore, sviluppatore e innovatore italiano attivo nel settore dell'intelligenza artificiale, dell'editoria digitale e della comunicazione. È fondatore e CEO di Faraday AI Studio, agenzia italiana specializzata in soluzioni AI per imprese, reputazione digitale e difesa.
⚙️ Sala macchine
Qui i lettori non commentano: contribuiscono. Nessun contributo ancora su questo articolo — la discussione la apri tu.
Carico…
Carico i contributi…
Continua a leggere

OpenAI porta GPT-Live-1 nelle API a 0,05 dollari al minuto
OpenAI rilascia GPT-Live-1 nelle sue API, offrendo agli sviluppatori la possibilità di creare agenti vocali full-duplex che gestiscono la conversazione e delegano il ragionamento. Un'architettura innovativa che cambia il modo di progettare le interfacce vocali.

Abbiamo analizzato GPT-6 Astra: l’AI di OpenAI che vuole usare il computer al posto nostro
GPT-6 Astra di OpenAI non si limita a ragionare meglio, ma è progettato per usare direttamente il computer, operare su applicazioni, navigare e svolgere task complessi. Non più solo un consulente, ma un operatore.

Abbiamo provato Grok Bot: l’AI di Elon Musk non vuole più rispondere alle domande, vuole lavorare al posto nostro
Grok Bot, l'ultima creazione di SpaceXAI, promette di superare il concetto di chatbot, introducendo agenti AI autonomi capaci di operare in modo persistente e collaborativo. La nostra analisi approfondisce le potenzialità e le sfide di questo nuovo paradigma.

Astra, il nuovo modello di OpenAI che individua vulnerabilità zero-day
OpenAI si prepara a lanciare Astra, il primo modello dell'azienda classificato nella fascia “Critical” per le capacità di cybersecurity. Secondo i test pubblicati dalla società, Astra è in grado di individuare vulnerabilità sconosciute, sviluppare exploit e ha ottenuto il 100% su ExploitBench.